Как устроена память Codex: что переносится между проектами
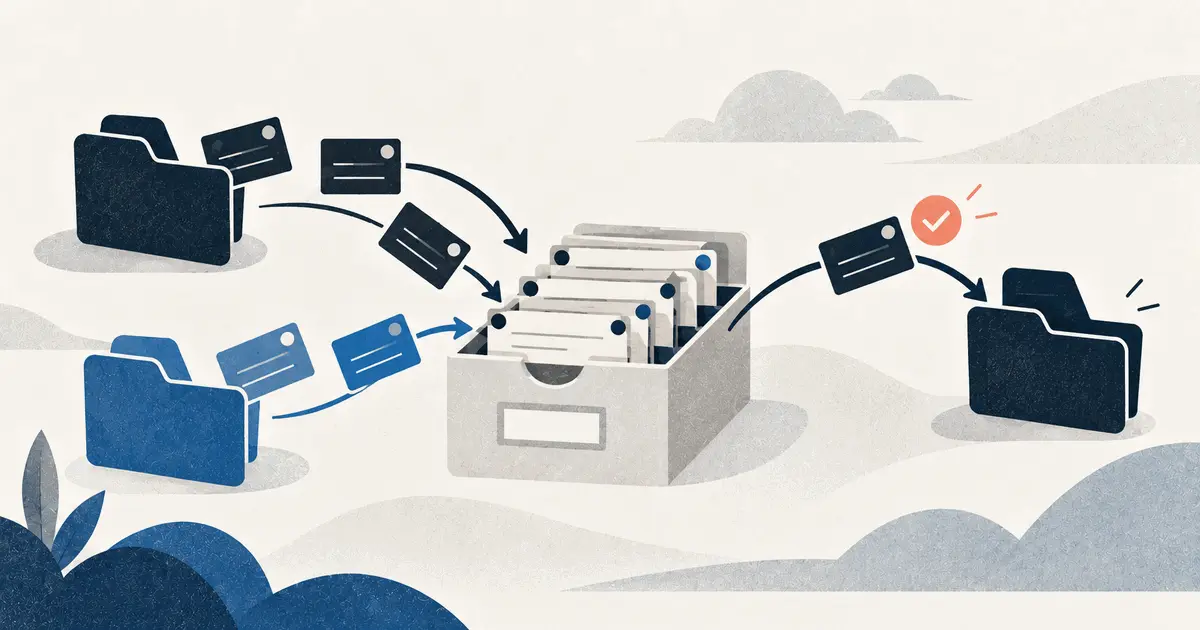
Новая сессия Codex может получать краткую сводку прошлой работы и читать подробности из файлов. Эту память создаёт и обновляет фоновый процесс по журналам прошлых сессий.
Если сводка есть, она передаётся в контекст. Без неё задача начинается без памяти по внешней стрелке. Фоновая ветка обрабатывает до 2 прошлых сессий с последней активностью от 6 часов до 10 дней назад.
Разбор основан на коммите OpenAI Codex 8308618. В его базовых настройках память выключена; доступность функции в вашей установке нужно проверять отдельно. Это разбор кода, без проверки на тестовых сессиях. Флаг функции.
Как история превращается в память
Процесс состоит из двух этапов.
1. Извлечение. Модель получает отфильтрованный журнал сессии, называемый в коде rollout, и возвращает резюме. Ей предписано сохранять предпочтения и исправления пользователя, проверенные способы работы, причины ошибок и ссылки на источники. Если полезного знания нет, допустим пустой результат. Записи сохраняются в базе. Реализация, инструкции V1.
Разовая просьба «покажи план перед этой правкой» не должна превращаться в постоянное правило. Этот пример прямо разобран в инструкциях V2. Соблюдение таких условий зависит от модели.
2. Объединение, или консолидация. Система выбирает записи из базы, синхронизирует файлы и через Git определяет, что изменилось. Если изменений нет и итоговые файлы корректны, агент объединения не нужен. Иначе он обновляет память. Одновременную консолидацию ограничивает глобальная блокировка. Git хранит локальную точку сравнения; отправка памяти в GitHub здесь не предусмотрена. Реализация.
Две версии памяти
В разобранном коммите есть V1 и V2; по умолчанию выбрана V1. README преимущественно описывает её. Настройки.
| Операция | V1 | V2 |
|---|---|---|
| Извлечение из сессии | Подробная запись raw_memory и резюме эпизода |
Резюме эпизода с задачами, исправлениями и результатами |
| Консолидация | Тематический справочник MEMORY.md, сводка, при необходимости skills/ |
Только сводка: предпочтения, подсказки и указатели на эпизоды по проектам и датам |
| Разрешение противоречий | Пересмотр тематических блоков по свежести и подтверждению; неопределённость сохраняется | Поздние исправления заменяют старые утверждения; разовые условия остаются при своей задаче |
| Воспроизведение | Сводка → поиск по справочнику → подходящие резюме или навыки | Сводка → резюме, если подробности могут повлиять на ответ |
| Забывание | Уборка неподтверждённых выводов из справочника и сводки | Уборка неподтверждённых выводов и указателей из сводки |
| Хранение | ~/.codex/memories/ |
~/.codex/memories_v2/ |
В V1 агент может оформлять повторяемые процедуры в навыки — инструкции для определённого вида работы. V2 составляет сводку с указателями на резюме сессий; промпт ограничивает её 10 000 байтами. В обеих версиях консолидация должна учитывать исправления пользователя и удалённые источники. Опция dual_write запускает обе цепочки, но контекст предоставляет выбранная версия. Контракт извлечения, объединение V1, V2, запуск.
Что читает новая сессия
В контекст — сведения, переданные модели для текущей работы автоматически попадает готовая сводка. Для неё задан бюджет 2 500 токенов — единиц текста модели. Длинная сводка обрезается. Подробности остаются в отдельных файлах. Бюджет, подготовка сводки.
В V1 инструкция предлагает искать ключевые слова в MEMORY.md, затем открыть одно-два подходящих резюме или навыка. В V2 агент идёт по указателям из сводки к нужным резюме, когда дополнительные основания, хронология или неопределённость могут изменить ответ. Если сводки достаточно, отдельное чтение не требуется. Чтение V1, V2.
Настройка dedicated_tools добавляет инструменты списка файлов, чтения, поиска и записи пользовательской заметки. Их локальный поиск работает по текстовым совпадениям. Модель подбирает слова для поиска; векторного поиска по смысловой близости в этом обработчике нет. Подключение инструментов, поиск.
Что обновляется и забывается
При объединении приоритет получают чаще использованные записи, затем — более свежие. Для никогда не использованных записей учитывается время обновления исходной сессии. В базовой конфигурации отбираются до 256 записей в пределах 30 дней неиспользования. Это отдельное окно для готовых записей; десятидневное окно выше относится к извлечению историй. Запрос отбора, настройки.
Система очищает устаревшие записи и резюме, а агент должен убрать выводы, лишившиеся источников. Эти правила не обещают полного удаления информации через 30 дней: исходные журналы и итоговые файлы — разные места хранения. Очистка, правила удаления.
Для просьб «запомни», «исправь» и «забудь» агент записывает заметку в extensions/ad_hoc/notes/. Напрямую менять сгенерированную память инструкции запрещают. Обработчик заметки только сохраняет файл; правку ещё должно применить последующее успешное объединение. Ответ «записал просьбу забыть» не подтверждает немедленного удаления старого текста. Инструкция, обработчик, правила заметок.
Общая память и границы проектов
Память общая для сессий, использующих одну директорию данных Codex — по умолчанию ~/.codex. Переменная CODEX_HOME позволяет выбрать другую директорию. Путь к сводке зависит от неё и версии памяти, а в запросе отбора историй нет фильтра по текущему проекту. Директории, отбор историй, путь к сводке.
Инструкции объединения требуют сохранять рабочую директорию, область действия и условия повторного использования записи. Это текстовые пометки для модели: отдельных границ доступа для Git-репозиториев — директорий проектов с историей изменений механизм не создаёт. Инструкции V1, V2.
Условный пример: в проекте A проверки запускают в контейнере, в проекте B — напрямую. Обе истории могут попасть в память. Запись о контейнере должна сохранить привязку к проекту A; перед новой проверкой агенту всё равно нужно свериться с текущей конфигурацией проекта.
Когда запускается память и нужно ли ждать
Обновление запускается при старте основной пользовательской сессии. Оно идёт в фоне, если функция включена, база доступна и хватает лимитов модели. Дочерние агенты и сессии без сохранения истории такой проход не запускают. Точка запуска.
Текущая задача не ждёт обновления. Если использование памяти включено и есть непустая memory_summary.md, её содержимое добавляется в контекст. Без сводки задача начинается без этой памяти. Подготовка контекста.
Фоновый процесс выбирает прошлые сессии, исключая текущую. По умолчанию последняя активность подходящей истории должна быть от 6 часов до 10 дней назад; за запуск обрабатываются до двух сессий. Эти параметры меняются в настройках. Отбор, базовые значения.
Шесть часов — условие отбора, а не таймер. Само достижение порога ничего не запускает. Только что законченная работа ещё слишком свежая, а неизменившаяся история двухнедельной давности уже не проходит базовое окно.
Настройки и обработка данных
Генерация и чтение регулируются отдельно: generate_memories задаёт разрешение генерации для новых сессий, use_memories — подключение памяти к контексту. Выключение настройки не очищает сохранённые данные. Конфигурация.
При извлечении журнал отправляется модели. Код маскирует распознаваемые секреты до отправки и в полученных полях; обнаружение всех секретов этим не гарантируется. Извлечение, обработка результата.
У агента объединения отключены внешние инструменты и повторное делегирование. Управляемая песочница — ограничение доступа программы к ресурсам — разрешает запись в директорию памяти и запрещает сеть. Если песочница родительской сессии отключена или управляется внешней средой, этот режим сохраняется. Настройка агента.
Постоянные правила проекта я бы хранил в AGENTS.md — файле инструкций для агента или документации. Сохранённая команда проверки может устареть; перед запуском нужно сверить её с конфигурацией проекта.
Термины
- Сессия — отдельная история работы с Codex.
- Rollout — журнал сообщений, действий и результатов сессии.
- Извлечение — создание записи по журналу сессии.
- Консолидация — объединение и исправление записей памяти.
- Контекст — сведения, переданные модели для текущей работы.
- Токен — единица представления текста для модели.
- Навык — инструкция для повторяемого вида работы.
CODEX_HOME— директория данных Codex, по умолчанию~/.codex.- Песочница — ограничение доступа программы к ресурсам.
Источники
Ссылки закреплены на коммите OpenAI Codex 83086188ae0614bd882818ff1aa23f3194962012. Повторная сверка кода: 21 октября 2026 года.
- README — исходное описание; некоторые пути и детали отстают от кода.
- Запуск, извлечение, объединение, отбор записей — исполняемая логика.
- Инструкции модели и подготовка контекста — как память записывается и читается.
- Настройки — версии и параметры; точные источники остальных утверждений приведены в тексте.
Все материалы по теме: «Организационная и агентская память».
Это черновик: текст и иллюстрации могут измениться после редакционного ревью.
Хотите внедрить это у себя?
Помогаю командам выстроить работу с ИИ-агентами и проверить эффект изменений на реальных задачах. Короткие заметки между статьями выходят в Telegram-канале.