Почему несколько AI-агентов сами по себе — не Mixture of Experts
MoE шире одной трансформерной архитектуры, но обычная система с ролевыми AI-агентами и координатором сама по себе не становится разреженным MoE.
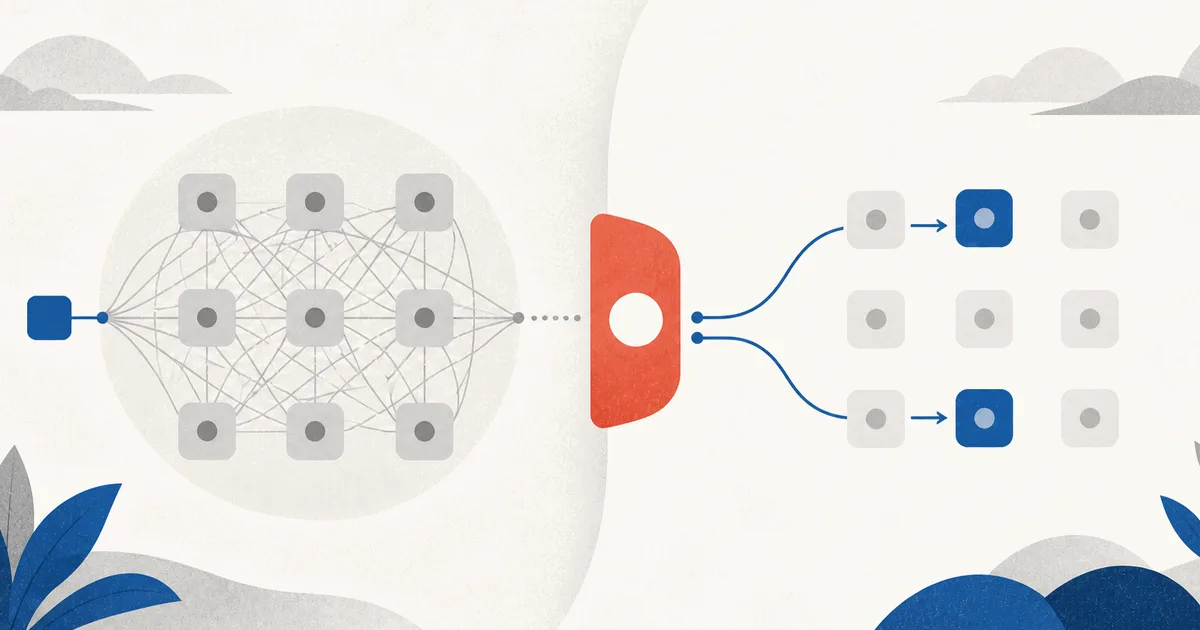
Систему из «архитектора», «разработчика» и «тестировщика» легко сравнить с Mixture of Experts: есть несколько исполнителей, а координатор выбирает подходящего. Но слово «эксперт» здесь обозначает разные вычислительные единицы.
Сам термин Mixture of Experts шире одной архитектуры. В статье речь прежде всего о разреженных MoE в современных языковых моделях. Их полезно отличать от Mixture-of-Agents и от прикладной схемы «координатор–исполнители».
Что называют Mixture of Experts
Mixture of Experts, или MoE, — семейство моделей, в которых управляющий механизм вычисляет веса экспертов или выбирает их для конкретного входа, а затем объединяет результаты. В исходной работе 1991 года локальные экспертные сети и управляющая сеть обучались совместно. Эксперты в общем определении MoE не обязаны быть блоками одной трансформерной модели.
В современных больших языковых моделях (LLM) под MoE обычно имеют в виду более узкую конструкцию — разреженный слой внутри модели. Вместо одного полносвязного блока в нём работает набор нейросетей-экспертов. Роутер выбирает для каждого входа только часть из них, а их числовые выходы объединяются.
В Sparsely-Gated MoE слой содержал до нескольких тысяч полносвязных подсетей. В Mixtral 8x7B на каждом MoE-слое роутер выбирает для токена двух экспертов из восьми. Выбор может меняться от слоя к слою и от токена к токену.
Разреженная активация позволяет увеличивать общее число параметров без пропорционального роста вычислений на токен. За это приходится платить обменом данных между устройствами и контролем нагрузки. Switch Transformer выбирает одного эксперта на токен. DeepSeekMoE добавляет постоянно активные общие эксперты и делит маршрутизируемых экспертов на более мелкие блоки, чтобы уменьшить избыточность между ними.
Почему эксперт разреженного MoE — не AI-агент
Эксперт разреженного MoE — обучаемая нейросеть, обычно полносвязный блок внутри слоя. Он получает числовое представление и возвращает новый вектор. У него нет собственной цели, истории действий или внешних инструментов; соседние токены одного предложения могут попасть к разным экспертам.
В этой статье AI-агентом называется система на уровне приложения. Она получает задачу и контекст, вызывает модель и инструменты, хранит рабочее состояние и возвращает текст, код или другой артефакт. При этом используемая агентом модель сама может содержать MoE-слои: это разные уровни одной системы.
Два многоагентных механизма
Mixture-of-Agents
В Mixture-of-Agents, или MoA, слово «агент» используется в более узком смысле: это отдельный экземпляр генерации LLM, которому не обязательны инструменты или собственное рабочее состояние. Такие агенты организованы в слои. Каждый агент следующего слоя получает ответы предыдущего слоя как дополнительный контекст и создаёт свой ответ.
В опубликованной схеме запрос проходит через всех агентов слоя. Это ансамбль — способ объединить несколько ответов — с последовательным синтезом, а не разреженный выбор части параметрических экспертов.
Координатор–исполнители
В исследовательской системе Anthropic ведущий агент создаёт исполнителей для отдельных направлений поиска и затем объединяет их отчёты. Каждый исполнитель работает в своём контексте и пользуется инструментами.
Единицей делегирования здесь становится содержательная подзадача. Число исполнителей определяет координатор. Из описанной архитектуры следует, что исполнители — отдельные агентные сессии, а не подсети совместно обучаемой с координатором модели. По данным Anthropic, такая система расходовала примерно в 15 раз больше токенов, чем обычный чат. Авторы также отмечают, что исследовательские запросы легче распараллелить, чем многие задачи программирования.
Сравнение без ложной эквивалентности
| Механизм | Что обрабатывается | Что выбирается | Как получается результат |
|---|---|---|---|
| MoE | Вход модели; в современных разреженных MoE — представление токена | Эксперты; роутер также задаёт коэффициенты их вклада | Числовые выходы экспертов объединяются с учётом коэффициентов |
| Mixture-of-Agents | Запрос и ответы предыдущего слоя | В опубликованной схеме агенты слоя не отбираются: работают все | Следующий слой получает все предыдущие ответы |
| Координатор–исполнители | Содержательная задача | Отдельные агентные сессии для выбранных подзадач | Координатор собирает отчёты или артефакты |
MoA объединяет несколько ответов без разреженной маршрутизации. Координатор может выборочно запускать исполнителей, но их работа не сводится к вычислению вектора внутри слоя.
Где заканчивается аналогия
Исследования разреженных MoE не отвечают, как делить инженерную задачу, когда запускать проверку безопасности или сколько агентов использовать. Выбор нескольких исполнителей похож на условное вычисление, но одного этого сходства недостаточно, чтобы отнести прикладную систему к разреженным MoE.
Нельзя буквально переносить и специальные термины. top-k — это выбор k экспертов с наибольшими оценками роутера; k может быть равен единице. Expert capacity — максимальное число токенов из одного пакета входов, которое обрабатывает эксперт, а load balancing — выравнивание нагрузки между экспертами. Общая ёмкость модели — другое значение слова capacity. Лимит времени агентной сессии, очередь ревью и стоимость внешних вызовов — другие инженерные величины.
Граница зависит от определения. Если приложение действительно использует обучаемую управляющую модель, которая взвешивает выходы специализированных моделей, его можно обсуждать как MoE более высокого уровня. Но обычная система с ролевыми агентами и координатором сама по себе не является разреженным MoE внутри LLM.
Источники
- Adaptive Mixtures of Local Experts — ранняя формулировка смеси локальных экспертов с обучаемой управляющей сетью.
- Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer — разреженный MoE-слой с обучаемым роутером.
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity — выбор одного эксперта на токен и инженерные проблемы разреженных моделей.
- Mixtral of Experts — выбор двух экспертов из восьми для каждого токена на каждом MoE-слое.
- DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models — общие и более мелкие маршрутизируемые эксперты.
- Mixture-of-Agents Enhances Large Language Model Capabilities — многоагентная архитектура с послойным объединением ответов.
- How we built our multi-agent research system — производственная схема «координатор–исполнители» и её ограничения.
Список не претендует на полный обзор MoE или многоагентных систем.
Хотите внедрить это у себя?
Помогаю командам перейти на агентную разработку: как советник, через обучение команды или внедрение изменений с проверкой эффекта по данным. Короткие заметки между статьями выходят в Telegram-канале.