Почему AGENTS.md недостаточно для долгоживущего AI-проекта
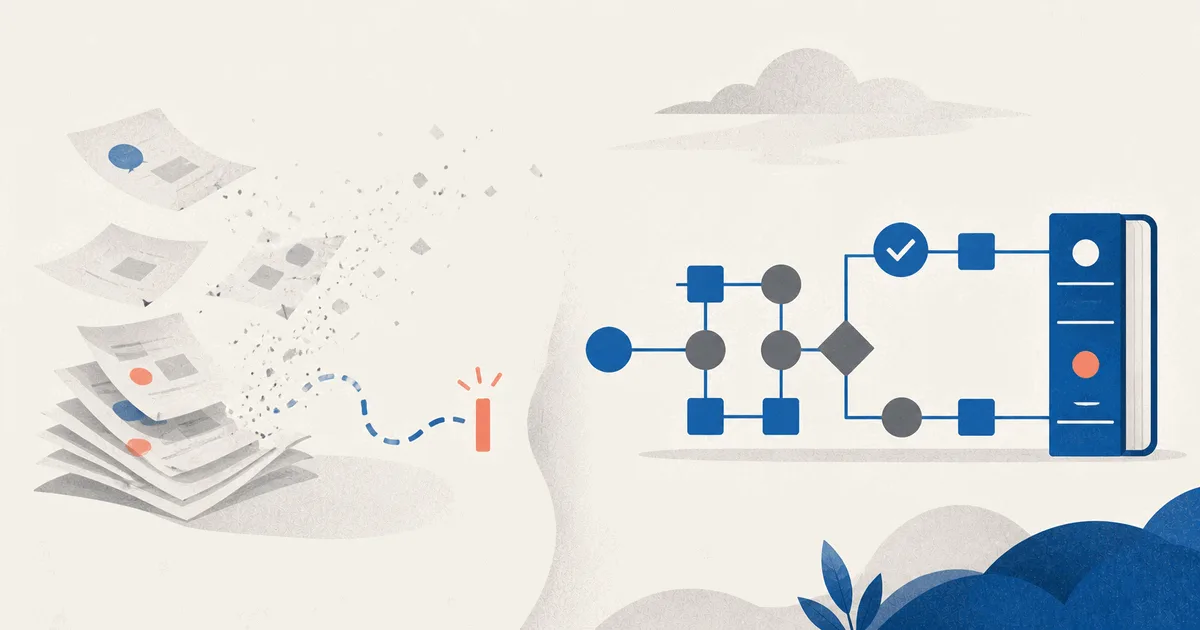
AGENTS.md хорошо отвечает на вопрос «как агенту начать работу». Он не должен в одиночку отвечать, что за продукт мы строим, какие решения уже приняты, какой lifecycle проходит задача и чем доказан результат.
Я люблю AGENTS.md. Это понятная точка входа: открываешь репозиторий, и там уже написано, какие файлы читать, какие команды запускать и где агент обязан остановиться.
Проблема начинается, когда в этот файл пытаются поместить весь проект. Он растёт, в нём смешиваются продуктовые факты, исторические решения, команды, текущие задачи и мелкие предпочтения. Любая правка требует прочитать всё заново. Свежая сессия всё равно не понимает, какой из абзацев — каноническая истина, а какой — след старой задачи.
Мой вывод: AGENTS.md должен быть маршрутизатором, а не монолитной памятью проекта.
Что AGENTS.md решает хорошо
Корневой instruction file полезен для небольшого набора устойчивых runtime-правил:
- где находится корневая документация;
- как собрать и проверить проект;
- какие каталоги нельзя читать без необходимости;
- какие операции требуют разрешения;
- какой язык, стиль и Git workflow приняты;
- куда идти за контекстом конкретной задачи.
Последний пункт ключевой. Сильный AGENTS.md не старается стать всеми документами сразу. Он указывает на индексы и правила владения.
Чего не хватает долгоживущему проекту
1. Явного владельца каждого факта
Если одно и то же правило записано в README, AGENTS.md, архитектурной заметке и плане фичи, оно не становится надёжнее. Появляются четыре версии правды.
Нужен Single Source of Truth: какой документ владеет правилом, а какие только ссылаются на него. Тогда конфликт разрешается по dependency tree, а не по интуиции агента.
2. Маршрута от задачи к нужному контексту
Агенту не нужен весь репозиторий в каждой сессии. Ему нужен минимальный набор канонических источников для конкретной задачи.
Это и есть context priming — подготовка контекста под задачу:
общий вход
     ↓
выбор lifecycle
     ↓
контекст нужного процесса
     ↓
фактическое состояние кода и тестов
Без такого маршрута есть две плохие крайности: либо агент читает всё, либо планирует по одному короткому промпту.
3. Lifecycle, который соответствует риску
Инцидент, мелкая правка, исследование, рефакторинг и большая фича не должны проходить один и тот же шаблон. В одном случае нужно сначала сдержать operational impact. В другом — сначала ответить на исследовательский вопрос. В третьем — достаточно малого изменения с известными проверками.
Поэтому в Memory Bank задача сначала маршрутизируется, а уже потом получает нужные артефакты и gates. Цель не в том, чтобы добавить бюрократию, а в том, чтобы не применять максимальный процесс к каждой мелочи.
4. Доказательств вместо отчёта «готово»
Для долгоживущего проекта недостаточно, чтобы агент написал «тесты прошли». Нужно знать:
- какое требование проверялось;
- какая команда или user journey наблюдались;
- на какой ревизии;
- каков фактический результат;
- что осталось непроверенным.
Так возникает traceability: задача связана с требованием, решением, изменением и наблюдаемым доказательством.
5. Памяти, которая переживает инструмент
Если важное решение живёт только в истории одной модели, проект привязан к этой сессии. Смена Codex на Claude Code, новый контекст или другой человек возвращают команду к реконструкции.
Файлы в Git не идеальны, но они дают свойства, которых нет у чата: diff, review, blame, стабильные ссылки, одинаковый доступ для людей и разных агентов.
Как устроен Memory Bank
Memory Bank разделяет контекст по владельцам:
| Слой | Какой вопрос решает |
|---|---|
product/ |
Зачем существует продукт, для кого и как измеряется успех? |
domain/ |
Какие термины, сущности, состояния и инварианты важны? |
engineering/ |
Какие архитектурные, тестовые и Git-правила приняты? |
ops/ |
Как работают окружения, релизы и runbooks? |
research/, prd/, use-cases/, epics/, features/, adr/
|
Как неизвестное, требования, решения и delivery-пакеты переходят по lifecycle? |
flows/ |
Какой минимальный процесс применить к этому типу задачи? |
Сама структура не даёт качества. Оно появляется, когда определены canonical owners, dependency direction, lifecycle gates и проверки. Иначе мы получим просто красиво разложенную свалку Markdown.
Минимальное внедрение
Полное заполнение всех разделов до первой задачи — плохая идея. Документация без опоры на факты создаёт видимость порядка, но не знание.
Начать можно так:
go install github.com/dapi/memory-bank-cli/cmd/memory-bank-cli@latestSOURCE_DIR="$(mktemp -d)/memory-bank"git clone --depth 1 https://github.com/dapi/memory-bank.git "$SOURCE_DIR"SOURCE_REF="$(git -C "$SOURCE_DIR" rev-parse HEAD)"memory-bank-cli init --source "$SOURCE_DIR" --template-version "$SOURCE_REF" --source-ref "$SOURCE_REF" --dry-runmemory-bank-cli init --source "$SOURCE_DIR" --template-version "$SOURCE_REF" --source-ref "$SOURCE_REF"memory-bank-cli doctorДля воспроизводимой автоматизации вместо latest-ревизий нужно закрепить release CLI и tag шаблона. В интерактивном знакомстве SHA хотя бы гарантирует, что preview и установка читают один и тот же checkout.
Затем:
- Открыть
memory-bank/README.mdкак корневой индекс. - Заполнить минимальный
product/context.md: кто пользователь, какая у него задача, какие границы у продукта. - Зафиксировать в
engineering/только реальные команды и инварианты. - Выбрать одну настоящую задачу и провести её через task routing.
- После задачи вернуть в canonical documents только устойчивое новое знание.
Для brownfield-проекта особенно важно не перепутать шаблон с фактом. Пустая таблица в domain/rules.md не доказывает, что доменные правила уже известны. Она только показывает место, где они будут жить после исследования.
Цена подхода
Memory Bank добавляет файлы, индексы и gates. Это не бесплатно:
- кто-то должен удалять устаревшее;
- ссылки и dependency tree нужно проверять;
- избыточный flow может тормозить маленькую правку;
- плохо адаптированный шаблон создаёт больше ложной уверенности, чем один честный README.
Поэтому маленькому проекту на несколько дней Memory Bank, скорее всего, не нужен. Достаточно AGENTS.md, README, пары тестов и чистого issue.
Подход окупается, когда:
- проект живёт дольше одной сессии;
- в нём работают несколько людей или агентов;
- ошибка в понимании дороже пары Markdown-файлов;
- задачи нужно возобновлять, проверять и передавать;
- важно различать «агент сказал» и «результат доказан».
Итоговая модель
AGENTS.md
  как начать и куда идти
        ↓
Memory Bank
  что за проект, кто владеет фактами,
  как идёт работа и чем она доказана
        ↓
код и наблюдаемое поведение
  как система работает сейчас
AGENTS.md и Memory Bank не конкурируют. Короткая инструкция направляет агента в систему долговечного контекста. Система, в свою очередь, не пытается описать реализацию лучше, чем сам код.
Граница простая:
- инструкция описывает маршрут и правила действия;
- проектная память — намерение, решения, требования и доказательства;
- код — фактическая реализация.
Когда эти три слоя не смешаны, свежий агент может начать с чистого контекста и всё равно продолжить ту же работу.
Ссылки
-
dapi/memory-bank— шаблон, маршруты и документация по внедрению. - Context priming — как подавать агенту не весь репозиторий, а нужную часть контекста.
- Ownership и безопасные обновления — контракт managed, adapted и user-owned файлов.
Хотите внедрить это у себя?
Помогаю командам перейти на агентную разработку: как советник, через обучение команды или внедрение изменений с проверкой эффекта по данным. Короткие заметки между статьями выходят в Telegram-канале.