Агентная разработка — это система: база знаний, процессы и память
Не начинайте внедрение с «вечной памяти» или выбора самого сложного агента. Сначала постройте минимальную производственную систему: человек, агент, база знаний и процессы получения проверяемого результата.
Когда мы обсуждаем агентную разработку, разговор быстро уходит к моделям: Claude или Codex, какой размер контекста, умеет ли агент помнить прошлые сессии. Из-за этого легко принять один инструмент за всю систему.
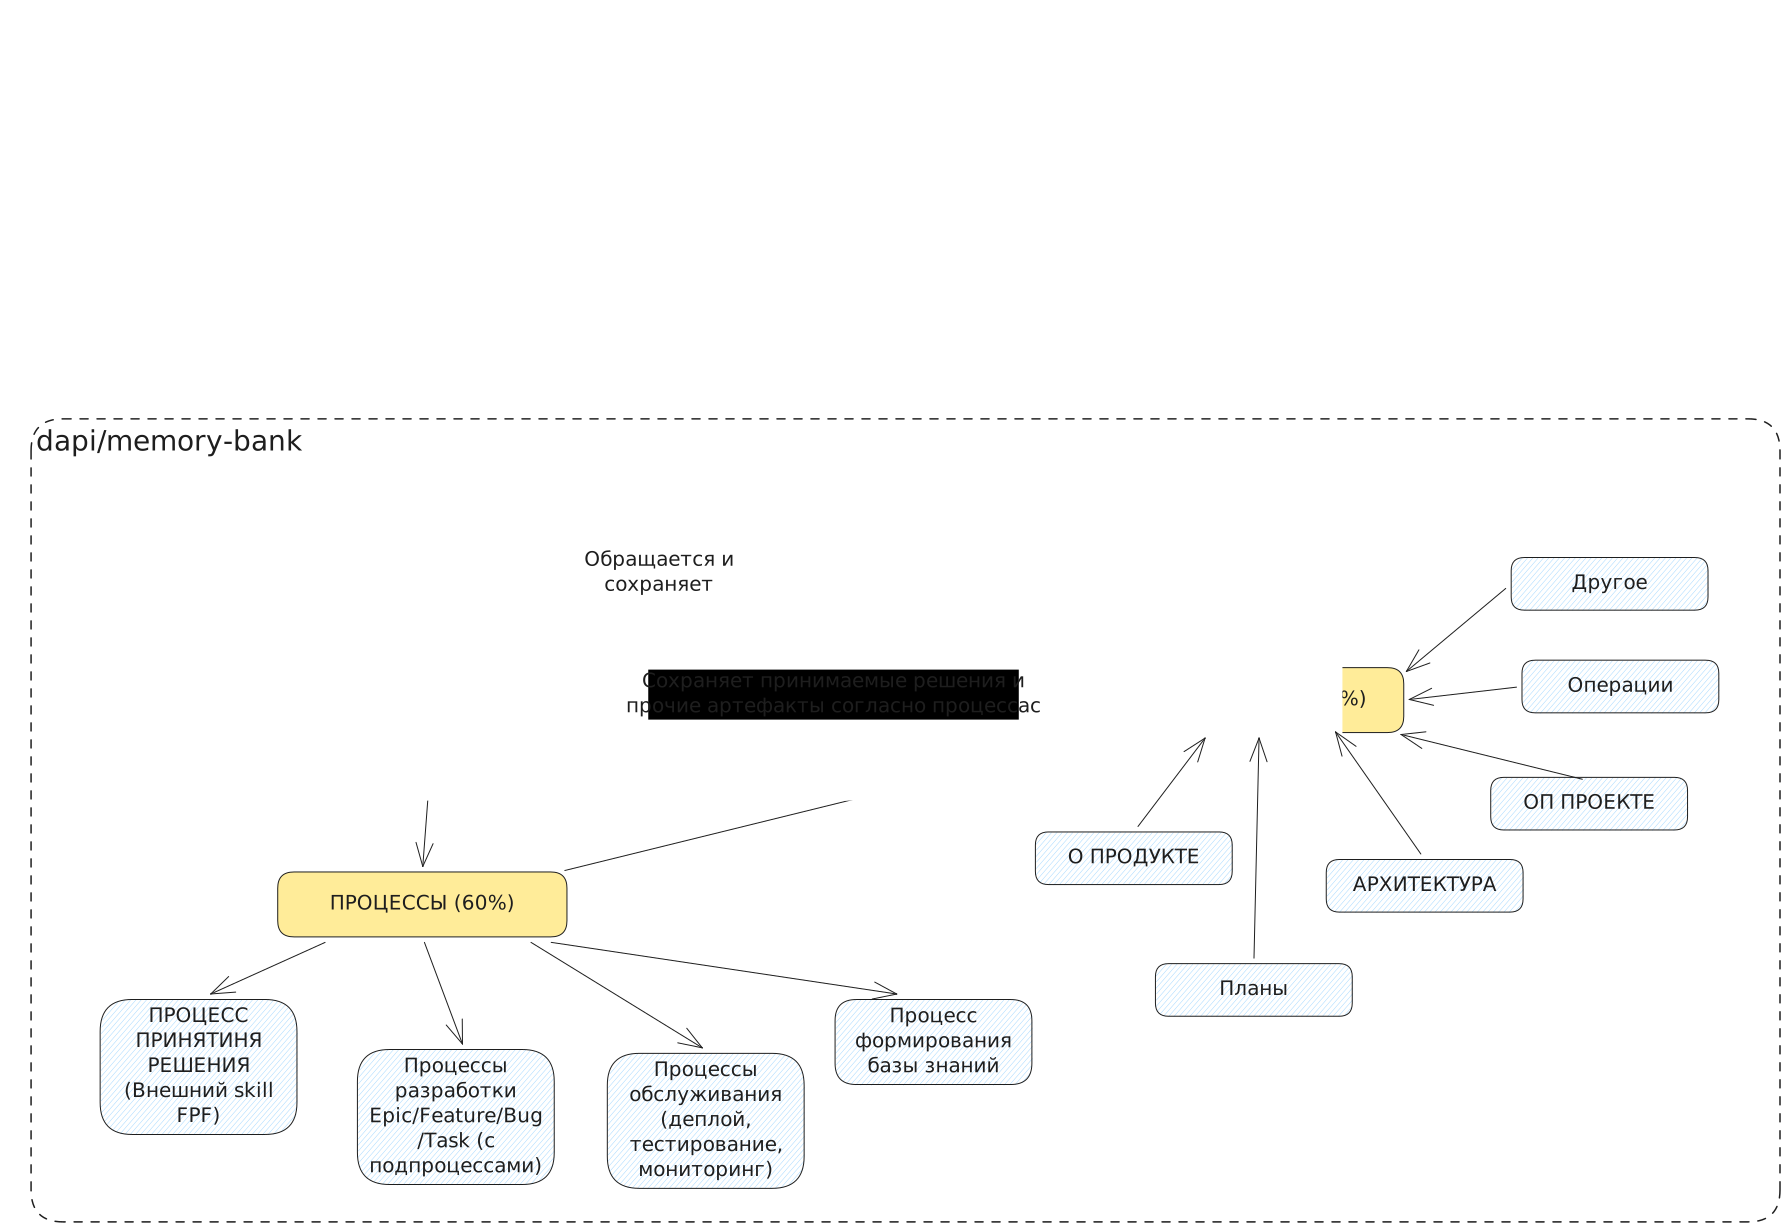
Но агентная разработка — человеко-машинная система. В ней человек выбирает проблему и принимает решения. Агент выполняет работу. База знаний хранит контекст продукта и проекта. Процессы определяют, как пройти от задачи до проверенного результата и что сохранить после завершения.
Память появляется позже — как отдельная инженерная проблема внутри harness, то есть рабочего контура вокруг модели.
Сначала — базовый контур
На первом шаге отдельная «память агента» не нужна для объяснения системы. Достаточно четырёх участников.
Человек
Человек остаётся владельцем цели и смысла. Он формулирует проблему, выбирает приоритет, принимает цену риска и подтверждает решения там, где недостаточно автоматической проверки.
Это не означает, что человек должен быть вечным справочником. Хорошая система уменьшает число вопросов к нему, но не пытается автоматизировать само целеполагание.
Агент
Агент умеет читать проект, искать данные, выполнять действия и проверять результат. Но сам по себе он просыпается в каждой новой сессии без понимания конкретного продукта. Фраза «ты помогаешь Васе разрабатывать систему» не даёт ему ни архитектуры, ни требований, ни критерия готовности.
База знаний
Поэтому агенту нужна база знаний. В ней находятся сведения:
- о продукте и его пользователях;
- о проекте и ожидаемых результатах;
- об архитектуре и принятых ограничениях;
- об операциях, окружениях и выпуске;
- о планах, активной работе и известных долгах.
Чем полнее и точнее эта база в границах текущей задачи, тем меньше агент вынужден угадывать. Качество результата определяется не только умностью модели, но и тем, доступны ли ей правильные знания в момент решения.
Процессы
База знаний без процессов остаётся складом документов. Процесс определяет, что читать, какое состояние должно быть достигнуто, какие проверки обязательны и когда можно переходить дальше.
Даже ссылка на SDLC уже задаёт маршрут. Более строгий процесс может сказать: сначала создать brief, проверить его по контракту, получить статус accepted и только после этого переходить к реализации.
В систему входят как минимум четыре семейства процессов:
- принятие решений и human gates;
- разработка epic, feature, bug и небольших изменений по разным lifecycle;
- тестирование, деплой и мониторинг;
- формирование и обслуживание самой базы знаний.
Процессы тоже лежат в базе знаний. Агент должен уметь найти нужный процесс, применить его к текущей задаче и вернуть результат правильному владельцу.
Как знания попадают в систему
У базы знаний два основных входа.
Первый — прямое внесение человеком. Так появляются цели, приоритеты, принятые ограничения и решения, для которых человек действительно является владельцем.
Второй — работа агента. Агент проводит контролируемое исследование, собирает источники, оформляет спецификацию, фиксирует принятое решение или сохраняет доказательство проверки. Но он не должен записывать в канонический документ всё, что прозвучало в рассуждении. В базу возвращаются только проверенные и устойчивые артефакты согласно процессу.
Например, спецификация — это не просто текст, который сгенерировала модель. Это зафиксированное решение о том, какой результат мы собираемся получить. Поэтому у неё должен быть владелец, статус и основание.
Ответ модели — ещё не знание
Модель хорошо умеет искать, сопоставлять и формулировать. Но её ответ нельзя автоматически считать фактом. В нём могут смешаться обучающие паттерны, найденные сведения и правдоподобная интерпретация.
Поэтому за знанием нужно ходить не «в модель», а через модель к источнику:
вопрос
  ↓
агент выбирает, где искать
  ↓
источник или каноническая база знаний
  ↓
проверяемое утверждение
  ↓
решение и сохранённый артефакт
Задача проектной системы — научить агента различать, когда нужен интернет, когда код, когда внутренняя база знаний, а когда решение человека.
Затем появляется отдельная проблема памяти
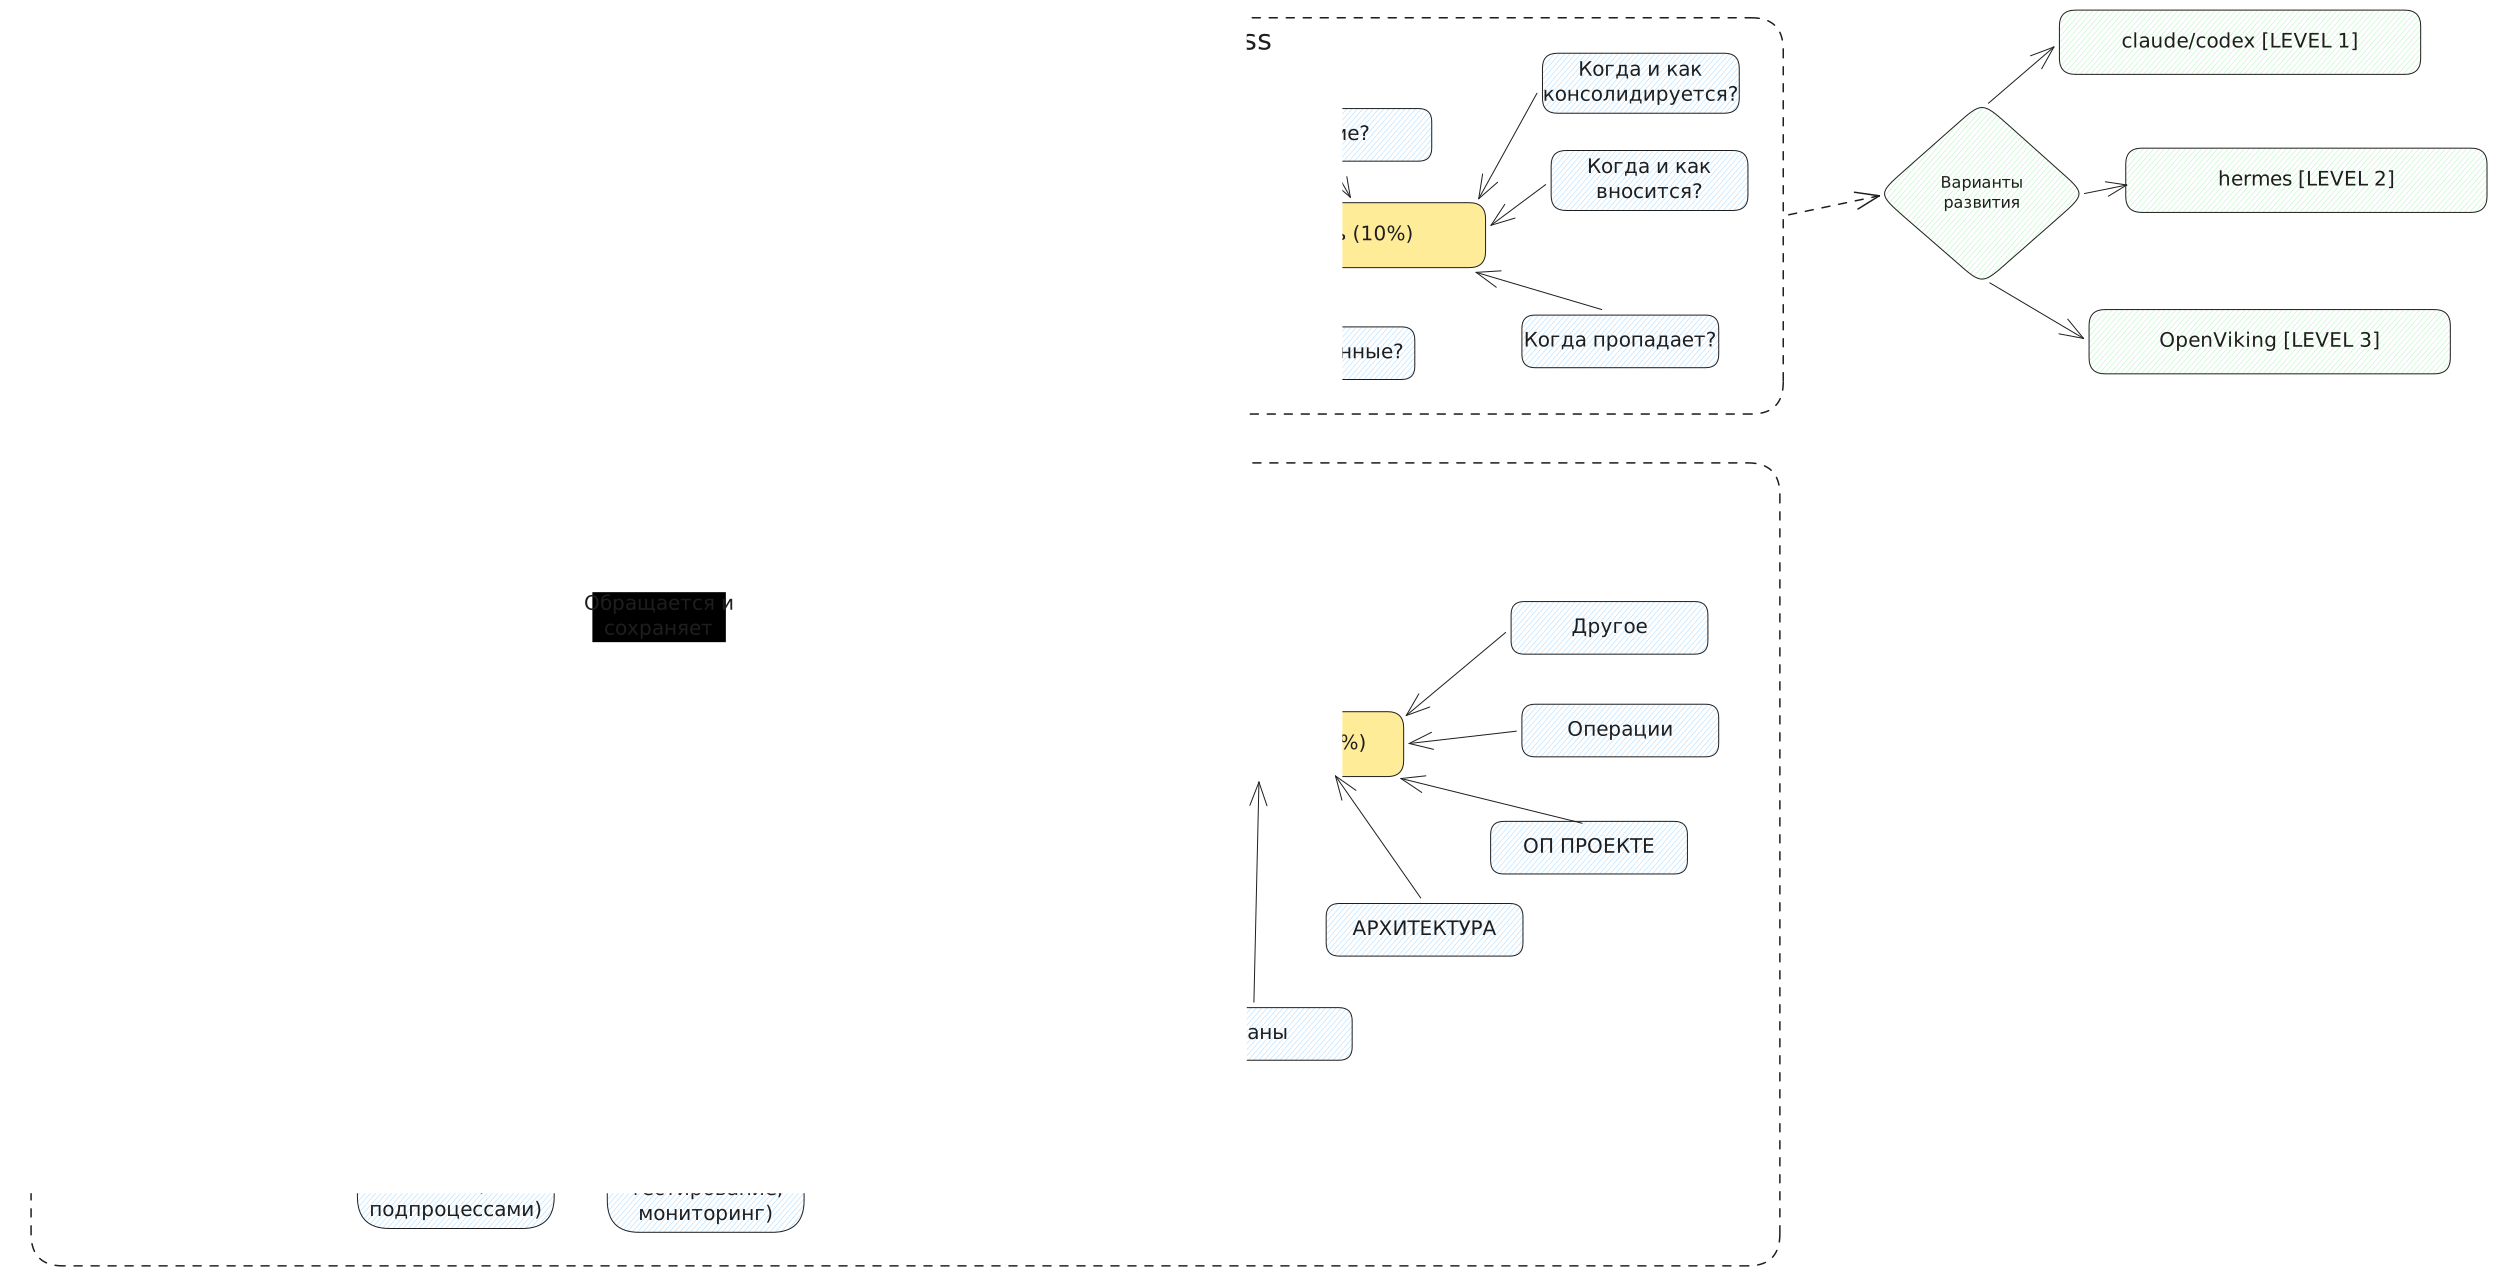
После того как базовый контур собран, становится видно: база знаний и память — не одно и то же.
База знаний отвечает на вопрос: что проект считает действующей истиной? У неё есть канонические владельцы, история изменений, источники и правила актуальности.
Память отвечает на другой вопрос: что из прошлого опыта нужно вернуть в рабочий контекст сейчас? Для неё приходится отдельно решать:
- какие данные сохранять;
- откуда они появляются;
- когда и как объединять похожие записи;
- как извлекать нужное для текущей задачи;
- когда запись устаревает и должна исчезнуть.
За нас этого не решает ни модель, ни размер контекстного окна. Любая автоматическая память содержит политику отбора и забывания, даже если она скрыта внутри продукта.
Проценты 90%, 60% и 10% на схеме — авторские ориентиры, а не результаты измерения и не части одной суммы. Они подчёркивают приоритет: сначала знания и процессы, затем улучшение памяти. В конкретном проекте пропорции будут другими.
Memory Bank — стартовая сборка, а не канон
dapi/memory-bank соединяет базу знаний и процессы самым дешёвым способом: через версионируемые текстовые файлы, маршруты и lifecycle. Его можно быстро добавить в проект, адаптировать под продукт и сразу получить структуру, которую понимают и человек, и агент.
Ценность этого подхода — в отношении цены внедрения к качеству результата. Не нужно сначала поднимать отдельный сервер контекста, настраивать поиск и проектировать автоматическую консолидацию.
Но Memory Bank не является единственным или окончательным устройством системы. Он не решает все процессы одним Markdown и не превращает любой записанный текст в актуальное знание. По мере роста проекта часть повторяемых процессов естественно переезжает в scripts, CLI и CI, а объём ручной документации может сокращаться.
По моему опыту, при заранее заполненном базовом контексте и реальной работе через процессы заметно полезная проектная база формируется примерно за две недели активного использования. Это не универсальная метрика: скорость зависит от проекта, частоты задач и того, действительно ли решения и доказательства возвращаются в канонические документы.
Что именно кладут в стартовую сборку
В разговоре о практическом внедрении Memory Bank 18 августа 2026 года его описали не как «папку с документацией», а как набор связных слоёв: конституцию или ДНК проекта, журнал архитектурных решений, описание домена, требования к продукту, use cases и процессы работы. Это полезная отправная точка, но не обязательная структура: в конкретном проекте состав должен отвечать на вопрос, какие знания агенту иначе пришлось бы угадывать.
Такая сборка работает, когда элементы не превращаются в дублирующую wiki. У документа есть один владелец знания, а остальные материалы ссылаются на него. Корневой файл агента не должен тащить весь набор в контекст: он даёт аннотированные индексы и маршрут к нужному слою. Это позволяет начать с малого, а не бороться с переполнением контекста созданием ещё одной свалки файлов.
Тот же подход применим к legacy-проекту. Сначала агент и инженер извлекают из кода и проверяют описание продукта, доменную модель, поддерживаемые сценарии и направление развития. Затем эти артефакты становятся проверяемым контекстом для последующих изменений. Код остаётся источником фактической реализации, но не подменяет собой зафиксированную проблему, ожидаемый результат и принятые ограничения.
Развивать память нужно по обнаруженному дефициту
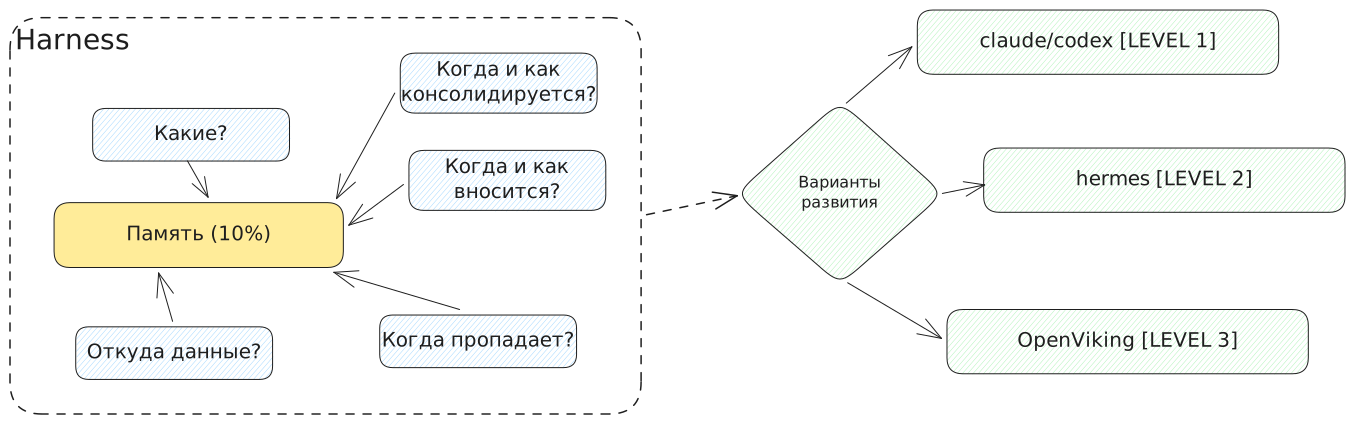
На схеме показаны три условных уровня. Это не рейтинг продуктов и не обязательная последовательность миграции.
Уровень 1: Claude или Codex плюс репозиторий
Агентный runtime уже даёт цикл работы, инструменты, инструкции и историю сессии. Долговечный контекст хранится рядом с кодом, а команда сама проектирует базу знаний, процессы и проверки.
Для многих проектов этого достаточно. Хорошо устроенный репозиторий может быть зрелее сложной memory-платформы без правил владения и обновления.
Уровень 2: память встроена в harness
Hermes показывает вариант, где профиль пользователя, память агента, проектные инструкции и процедурные skills встроены в один runtime. Часть сохранения и извлечения опыта переезжает из проектных соглашений в сам инструмент.
Это снижает трение, но не отменяет главный вопрос: какая запись является персональной памятью агента, а какая — канонической истиной проекта?
Уровень 3: контекст становится отдельной инфраструктурой
OpenViking выносит memory, resources и skills в отдельную базу контекста с иерархией, семантическим поиском и прогрессивной загрузкой. Такой слой может обслуживать разные агентные runtimes.
Переход оправдан, когда простой навигации по репозиторию уже не хватает и дефицит можно назвать: агент систематически не находит существующие знания, контекст слишком велик, консолидация стала ручным узким местом или нескольким агентам нужен общий механизм retrieval.
Ставить специализированную систему «на вырост» дорого. Появляются настройка, обслуживание, сетевой слой и ещё одно место возможного рассогласования. За время преждевременной миграции команда могла бы решить несколько продуктовых задач и точнее понять, какой именно дефицит памяти у неё возник.
Перепрыгнуть этап наблюдения нельзя. Решение о следующем уровне принимает команда на основании повторяющейся проблемы, а не модности инструмента.
Практическая последовательность внедрения
Схема задаёт не перечень документов, которые нужно написать заранее, а порядок наращивания работающей системы. В разговоре он звучал так: получить полезный контур самым дешёвым способом, поработать в нём, увидеть реальный дефицит и только после этого добавлять следующий слой.
- Возьмите простую стартовую сборку. На первом уровне достаточно Claude или Codex, репозитория и готового каркаса вроде Memory Bank. С нуля изобретать уникальную систему для каждого проекта не требуется.
- Адаптируйте базу знаний под конкретный проект. Заполните сведения о продукте, ожидаемых результатах, архитектуре, операциях и планах. Удалите чужие примеры и настройте маршруты, по которым агент находит нужные знания и процессы.
- Запустите через неё реальные задачи. Процессы должны не просто ссылаться на документы, а возвращать в базу принятые решения и проверенные артефакты: спецификации, архитектурные решения, отчёты о проверке. Так база начинает пополняться работой, а не отдельным проектом по написанию документации.
- Подпиливайте систему по фактическому использованию. Подходящие шаблоны и процессы оставляйте, неподходящие меняйте или удаляйте. Memory Bank здесь — исходная сборка с хорошим отношением цены внедрения к результату, а не канон, который нужно сохранять неизменным.
- Выносите повторяемые операции из текста в инструменты. Когда устойчивый этап уже понятен, его можно переносить в scripts и CI. Это уменьшает объём инструкций, которые агенту приходится каждый раз читать и интерпретировать.
- Усложняйте память только по названному дефициту. Если агент систематически не находит существующие знания, не справляется объём контекста или нескольким агентам нужен общий retrieval, появляется основание рассматривать Hermes, OpenViking или собственную инфраструктуру. До такого наблюдения переход добавляет стоимость, но не гарантирует лучший результат.
Эту последовательность нельзя честно перепрыгнуть: решение о следующем уровне принимается из опыта работы предыдущего, а не из сравнения списков функций инструментов.
Вывод
Агентная разработка начинается не с выбора самой умной модели и не с установки «вечной памяти». Она начинается с производственной системы, в которой человек задаёт цель, агент выполняет работу, база знаний хранит действующую истину, а процессы доводят изменение до проверяемого результата.
Память усиливает эту систему, но не заменяет её. Memory Bank может быть эффективной первой сборкой. Hermes или OpenViking могут закрыть следующий обнаруженный дефицит. Однако технология не освобождает команду от проектирования источников знания, правил обновления и момента, когда запись должна быть забыта.
Источники
- Авторское объяснение схемы на рабочей встрече 20 августа 2026 года; статья переработана по каноническому сырому транскрипту.
- Рабочий разговор «Vidmsg ai» 18 августа 2026 года — практическая вводная о слоях Memory Bank, аннотированных индексах и восстановлении контекста legacy-проекта. Это исходный разговор, а не независимое подтверждение общих утверждений статьи.
- Редактируемая исходная диаграмма в Excalidraw — источник трёх SVG-вариантов, использованных в статье.
- Harness engineering: leveraging Codex in an agent-first world — опыт OpenAI с базой знаний в репозитории, progressive disclosure и механической проверкой документации.
- Unlocking the Codex harness: how we built the App Server — состав Codex harness: agent loop, lifecycle сессий, инструменты, sandbox и расширения.
- Manage Claude's memory — иерархия пользовательских и проектных инструкций Claude Code.
dapi/memory-bank— стартовая реализация версионируемого контекста, правил владения и delivery processes.- Hermes Agent: Which file does what? — разделение пользовательского профиля, памяти агента и проектных инструкций.
- OpenViking architecture — отдельная база контекста для memory, resources и skills.
Хотите внедрить это у себя?
Помогаю командам перейти на агентную разработку: как советник, через обучение команды или внедрение изменений с проверкой эффекта по данным. Короткие заметки между статьями выходят в Telegram-канале.