Можно ли автоматизировать разбор и устранение инцидентов? Опыт небольшой команды
Пять инцидентов AAA показывают, какие шаги можно поручить ИИ-агенту и где нужен человек.

В AAA Codex помогал разбирать инциденты, но полностью автоматическое устранение инцидентов этот опыт не подтвердил. Исправление и восстановление работы проверяли люди.
В AAA над финансовым сервисом работали разработчик, инженер поддержки, который также тестировал продукт, и Данил, внедрявший подход с ИИ. Выделенного системного администратора и отдельной команды по надёжности не было. Команда использовала уже имевшиеся Mattermost для обсуждений, Docmost для документов, Google Sheets для журнала и GitHub для задач и кода. Денежную экономию не измеряли.
Мы восстановили по рабочим записям пять инцидентов 2026 года, где прямо указан Codex — ИИ-агент, помогающий исследовать данные и работать с кодом. Мы разобрали уже произошедшую работу, отделяя действия Codex от работы других моделей и людей. Если время или результат нельзя подтвердить записями, мы не оценивали их задним числом.
Как выглядел минимальный процесс
Для каждого инцидента создавали сообщение в Mattermost, документ разбора инцидента (Post-Incident Review, PIR) в Docmost и строку в общем журнале. В разборе записывали, что произошло, как это повлияло на работу, какую причину подтвердили и что нужно сделать, чтобы проблема не повторилась.
В журнал заносили любое событие, мешавшее работе команды или пользователей, а не только сбой работающего сервиса или ошибку в коде. Там были технические, организационные и связанные с безопасностью проблемы, а также случаи, которые после проверки не оказались инцидентами.
Реакции под сообщением показывали состояние работы: 👀 — инженер взял проблему,
🏁 — исправление или временный обход готов к проверке, ✅ — проверено, что
пользователь снова может работать. Дальнейшее обсуждение оставалось под тем же
сообщением.
Возобновление работы не закрывало разбор. По принятому правилу разбор закрывался, только когда команда выполняла и проверяла задачи против повторения сбоя. Записи прошлых лет не всегда позволяют подтвердить, что правило соблюдалось в каждом случае.

Журнал отдельно от разбора
Обсуждение в Mattermost показывало, что происходит сейчас. Журнал в Google Sheets помогал видеть состояние всех инцидентов: по одной строке на разбор с номером, затронутым сервисом, ответственным, статусом, датами и задачами.
Время восстановления часто не записывали: во время сбоя было не до таблицы, а потом к ней не возвращались. Даты задач позже находили в GitHub, но дата изменения кода не доказывает, что сервис уже заработал. Для этого нужно подтверждение в разборе, обсуждении, журнале работы программы или сообщении ответственного.
Ход расследования и проверку причины оставляли в документе разбора. Так журнал можно было быстро просматривать, не превращая каждую строку в длинный отчёт.
Что получилось в пяти инцидентах
В пяти разборах 2026 года Codex назван прямо. Возможно, его применяли и в других случаях, но записи этого не подтверждают.
| Эпизод | Что сделал Codex | Время | Где потребовался человек |
|---|---|---|---|
| Оценка масштаба | Быстро оценил масштаб сбоя и выделил два разных признака ухудшения работы | 2–3 минуты | Основная причина и восстановление ещё не были подтверждены |
| Разбор повторяющейся ошибки | Подтвердил, что все 29 попыток завершались одной ошибкой, и выяснил, почему система отклоняла три доступных варианта | Около 64 минут до подтверждения причины | Требовались решение владельца и изменение работающего сервиса; расследование само по себе работу не восстановило |
| Инцидент с поздним обнаружением | Начал диагностику примерно в течение минуты и позднее выполнил итоговую проверку | 8 минут 14 секунд до первой успешной авторизации; 15 минут 21 секунда до первого рабочего запроса | Сбой начался более чем за два часа до сообщения о нём; проблему нужно было замечать раньше |
| Путь от причины к коду | Примерно за 65 минут подтвердил причину и создал задачу на исправление | Несколько дней до выпуска исправления | Часть кода подготовила другая модель; решение и проверку выполнил человек |
| Риск диагностики | За 81–84 минуты подтвердил ключевые признаки причины по снимку данных | Около четырёх дней до восстановления | Запрос только для чтения исчерпал память, и система остановила рабочую программу; настройки изменил человек |
Даже запрос только для чтения может повредить работающему сервису. Проверкам тоже нужны ограничения по нагрузке.
Что показала проверка всего реестра
К 9 сентября нумерация дошла до PIR-217; в журнале было 214 уникальных записей, из них 197 за 2026 год. Мы заново распределили записи по причинам: 13 без категории проверили по разборам, 39 с меткой «Курсы обмена» разделили по типу причины, а сетевые проблемы и свойства системы включили в категории инфраструктуры и архитектуры.
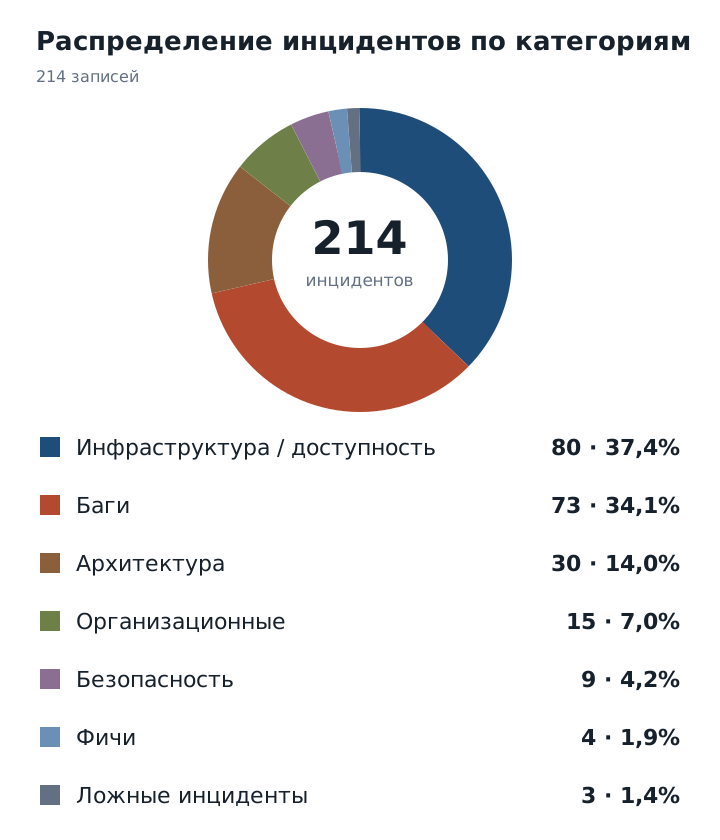
Больше всего записей связано с инфраструктурой и доступностью — 80 из 214, с ошибками в коде — 73 и с устройством системы — 30. Вместе это 183 записи, или 85,5% журнала. Остальные касаются организации работы, безопасности, новых функций и случаев, которые не оказались инцидентами.
До проверки дата восстановления была заполнена только в 28 из 214 строк, а длительность сбоя — в трёх. При этом 201 строка была помечена закрытой. По одному статусу нельзя проверить, выполнили ли задачи против повторения.
Мы проверили 213 доступных документов разбора, 23 обсуждения в Mattermost, 189 ссылок на задачи и изменения кода в GitHub, сведения о выпусках и журналы работы программ. Это добавило 353 подтверждённых значения, в том числе даты восстановления для 64 записей. Всего подтверждённая дата восстановления есть теперь у 92 из 214 инцидентов. Для остальных 122 её установить не удалось.
Автоматизация не восстановит отсутствующее свидетельство. Чтобы измерять время реакции и восстановления, его нужно фиксировать во время инцидента.
Что удалось автоматизировать
| Уровень | Что подтвердил кейс |
|---|---|
| Агент | Собирал хронологию, оценивал масштаб, проверял возможные причины, готовил черновик разбора и искал пропуски в журнале |
| Агент с проверкой человека | Помогал готовить исправление и изменять код; человек проверял результат по заданным критериям |
| Человек | Выбирал временное решение, принимал риск, менял работающий сервис, подтверждал восстановление и закрывал разбор после проверки задач против повторения |
Вывод из опыта AAA
В AAA агент помогал расследовать инциденты и готовить исправления, но люди принимали решения и подтверждали результат. Некоторые причины удавалось подтвердить примерно за час-полтора; от этого до восстановления сервиса иногда проходили дни. Снижение среднего времени восстановления, затрат труда и расходов мы не измеряли. Переносить результат на другие команды без проверки нельзя.
Если хотите повторить процесс, начните с одного обсуждения на инцидент, одного документа разбора и журнала. Отмечайте время восстановления сразу, а разбор закрывайте после проверки задач против повторения. Для этого есть схема процесса, шаблон разбора и шаблон журнала.
Термины
- ИИ-агент — программа, которая по поручению человека исследует данные, работает с кодом и предлагает следующий шаг.
- Разбор инцидента (PIR) — документ о влиянии сбоя, ходе расследования, подтверждённой причине и задачах против повторения.
Хотите внедрить это у себя?
Помогаю командам перейти на агентную разработку: как советник, через обучение команды или внедрение изменений с проверкой эффекта по данным. Короткие заметки между статьями выходят в Telegram-канале.